Google 将支持统一 AI 训练控制:外贸企业应该允许 AI 使用网站内容吗?
2026 年 10 月 30 日,Google Search Central 发布了一项值得网站所有者关注的公告:
Google 计划支持一种统一的 AI 训练控制机制,让网站能够更方便地决定是否允许 AI 服务商使用自己的内容进行模型训练。
这项机制将基于互联网工程任务组(IETF)AIPREF 工作组推动的标准提案,利用网站已有的 robots.txt 文件表达内容使用偏好。
根据 Google 公告,计划于 2027 年提供支持。
对普通用户来说,这可能只是一条技术新闻。但对依靠 Google 获取海外采购商的外贸 B2B 企业来说,背后其实有一个非常现实的问题:
如果 AI 可以读取、学习甚至引用我们的网站内容,企业究竟应该欢迎它,还是限制它?
[图片占位 1:文章封面。Google 搜索、AI 大模型、企业英文网站三者之间的关系,现代简洁科技风,留白充足,16:9。建议标题文字:企业网站内容,该不该开放给 AI?]
一、Google 这次究竟宣布了什么?
过去,网站所有者如果希望限制不同 AI 公司使用自己的内容,通常需要分别了解各家公司的爬虫及控制规则。
例如 Google 提供了 Google-Extended,允许网站表达针对部分 Gemini AI 产品的内容使用偏好。
而其他 AI 服务商也可能有不同的爬虫标识和控制方式。
问题在于:当越来越多 AI 服务商参与网页抓取、训练和内容检索时,让企业为每一家单独配置规则,会逐渐增加管理成本。
Google 此次宣布的方向,就是支持一种更统一的机制。
按照 2026 年 10 月发布的技术提案,网站未来可以在 robots.txt 中通过专门的策略标识,表达是否允许内容用于 AI 模型训练。
例如,提案中使用:
User-Agent: __usage_ai-training
Disallow: /
它表达的是不希望整个网站的内容被用于 AI 训练的偏好。
请注意:以上只是当前提案中的技术示例,并不代表 Google 已在 2026 年 11 月正式启用这一机制。现阶段不建议企业直接照抄到生产网站。
Google 预计在 2027 年支持该机制,最终执行方式仍可能随着标准制定而调整。
二、禁止 AI 训练,是否意味着 Google 不再收录网站?
并不是。
这是外贸企业最容易产生误解的地方。
网站被 Google 搜索收录、被 AI 模型用于训练,以及被 AI 应用实时引用,实际上是三个不同的概念。
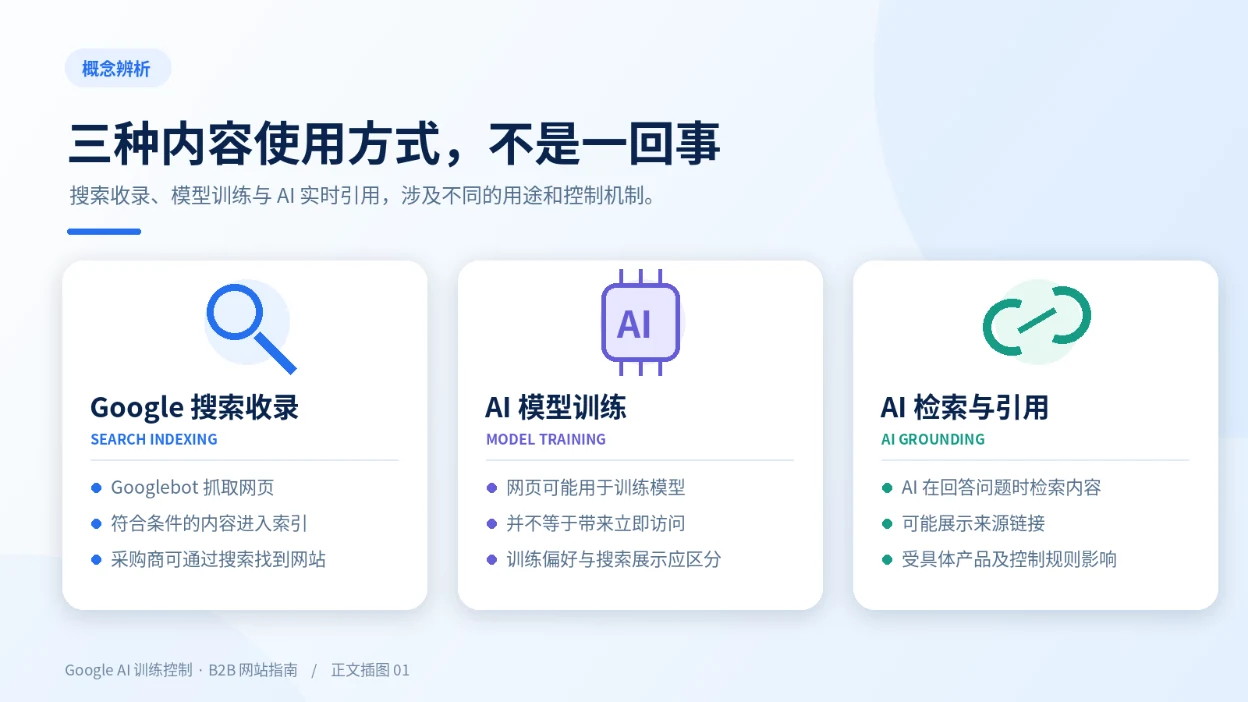
1. Google 搜索收录
Googlebot 抓取网站页面,将符合条件的内容纳入搜索索引,让海外采购商能够通过关键词找到企业。
对于以询盘为目标的外贸企业,这仍然是非常重要的获客渠道。
2. AI 模型训练
AI 服务商可能使用符合其内容获取与使用规则的网页数据,训练未来的模型。
这并不等于某个 AI 系统会立即把企业页面展示给采购商,也无法保证因此产生访问或询盘。
3. AI 应用引用与检索
例如用户使用 Gemini 查询某类工业产品供应商时,AI 应用可能结合搜索索引中的内容,提供解释、来源链接或相关网页。
这种方式与模型训练不同,但某些产品的控制机制可能同时涉及训练与内容引用。
[图片占位 2:三栏信息图。第一栏 Google Search:搜索收录与链接;第二栏 AI Training:模型训练;第三栏 AI Grounding:实时检索与引用。用三个清晰独立的模块解释区别,浅色背景,现代简洁风格,16:9。]
Google 官方特别明确:
Google-Extended 不影响网站是否进入 Google Search,也不是 Google Search 的排名信号。
但同时,Google-Extended 的控制范围涉及 Gemini 模型训练,以及部分 Gemini 产品通过搜索结果进行内容引用的能力。
所以,不能简单地说“关闭 AI 训练绝对不会影响任何 AI 相关曝光”。
正确的理解是:
限制 AI 内容使用与限制传统搜索收录不同,但具体会影响哪些 AI 产品,需要看相应的官方规则。
三、对外贸 B2B 企业来说,网站内容究竟有什么价值?
我们可以从一个简单场景来看。
假设一家中国制造商生产工业阀门,网站上有完整的英文产品页面,包括:
- 产品型号与规格
- 材质和适用介质
- 压力等级
- 使用行业
- 生产能力和定制选项
- 产品图片、认证及应用案例
过去,海外采购商主要通过 Google 搜索产品关键词,进入这些页面了解供应商。
随着 AI 搜索和 AI 助手逐渐融入信息检索过程,采购商还可能提出更复杂的问题:
“哪些供应商能够生产适用于特定工况的阀门?”
或者:
“这种阀门与另一种结构有什么区别?应该如何选择?”
如果企业网站本身具备清晰、真实、结构化的技术资料,就有条件成为搜索系统和 AI 检索系统理解企业能力的参考来源。
当然,公开内容并不保证一定会被 AI 引用,更不意味着开放 AI 训练就能提高 Google 排名。
但对希望被海外采购商发现的企业而言,公开资料的可发现性本身就具有商业价值。
四、是不是应该把所有内容开放给 AI?
我的建议是:公开营销资料与商业敏感信息应该区别对待。
对于大多数以海外获客为目的的外贸企业官网,并没有必要因为担心 AI 训练,就立即限制所有公开内容。
但这不等于企业应该把所有资料都放到互联网。
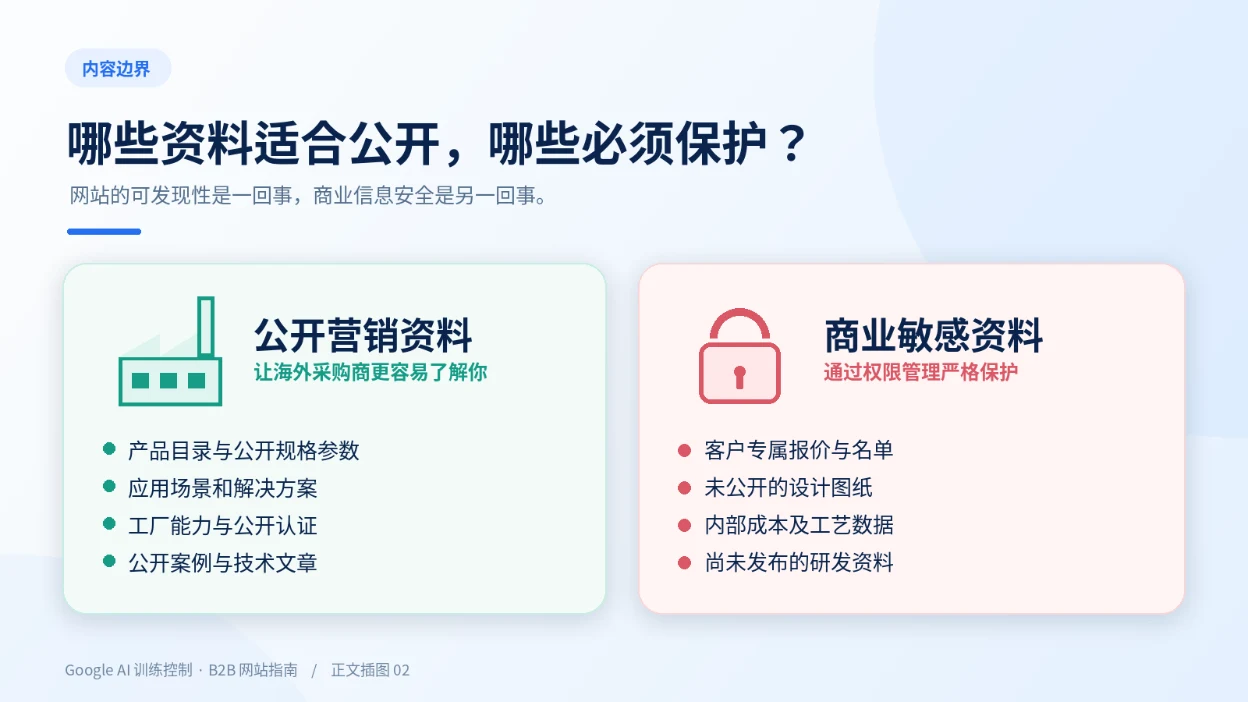
可以把内容分为两类。
第一类:希望客户主动找到的公开资料。
例如企业介绍、产品目录、公开规格、应用场景、产品图片、行业技术文章、公开认证和案例。
这些内容的核心目的就是让潜在客户了解企业。
建议优先确保它们可被正常抓取、理解和检索,并在明确各 AI 产品影响之后再决定是否限制其训练用途。
第二类:不应该公开的商业资料。
例如客户专属报价、未公开图纸、内部成本、特殊工艺参数、客户名单、尚未发布的产品研发资料。
这些信息应当通过账户权限、服务器访问控制和资料管理制度保护。
尤其要注意:
robots.txt 不是保密系统。
它主要用于表达抓取规则或使用偏好,不能替代密码保护,也无法保证所有第三方服务都会遵守。
真正的商业机密,不应仅依靠一条机器人规则进行保护。
五、WordPress 外贸网站现在需要调整什么?
对于已经正常运行的 WordPress 企业站,我建议先做三件事。
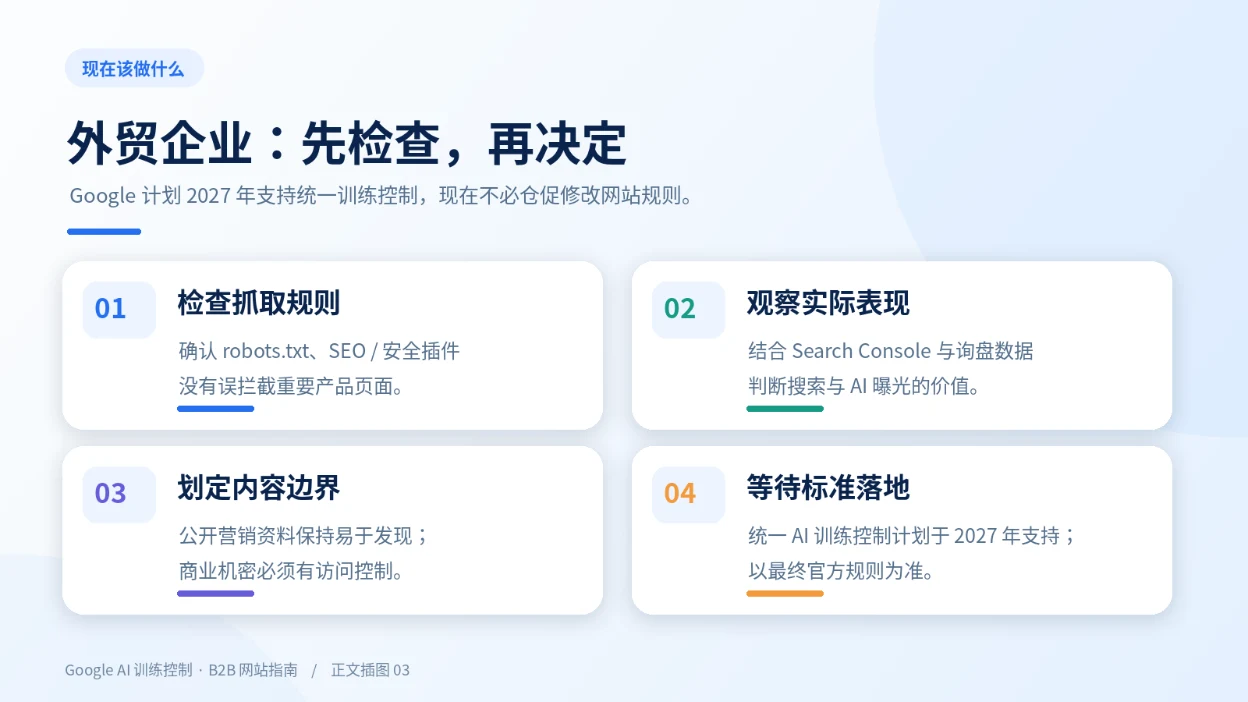
1. 检查 robots.txt 是否存在误拦截
一些网站使用 SEO 插件、安全插件、Cloudflare 或自定义服务器规则管理爬虫。
需要确认这些规则没有意外阻止 Googlebot 抓取重要的产品页面、图片和技术内容。
也不要把 Googlebot、Google-Extended 和其他 AI 爬虫简单视为同一种东西。
2. 先观察真实搜索表现
继续使用 Google Search Console 了解企业网站的收录、搜索曝光、访问及相关 AI 搜索表现。
对于以询盘为目标的 B2B 网站,更重要的是实际业务结果,而不是某个 AI 爬虫是否访问过网站。
建议重点观察:
- 哪些产品和解决方案页面获得曝光
- 哪些页面带来了有效访问
- 网站是否获得了相关的 AI 搜索曝光
- 表单、邮箱及其他渠道是否产生真实询盘
3. 不要急于使用尚未正式落地的新标准
此次公告公布的是一项计划于 2027 年支持的机制,而不是要求所有网站立即执行的新规则。
现有的 Google-Extended 机制仍然可用。
对于没有明确内容授权或商业限制需求的外贸 B2B 网站,没有必要为了追赶新技术而仓促修改配置。
等到统一标准成熟后,再根据企业的市场目标和内容保护需求做出选择,更为稳妥。
六、未来企业网站需要重新思考内容价值
过去,很多企业把网站理解为一份在线产品画册。
后来,网站逐渐承担搜索获客、品牌展示和询盘转化的功能。
如今,网站又增加了一层价值:
它可能成为搜索引擎与 AI 系统理解企业业务的公开信息来源。
这也意味着,企业真正应该积累的不是大量重复的 AI 文章,而是能够证明自身能力的高质量资料:
真实的产品参数、应用场景、技术知识、生产能力、认证和客户案例。
这些资料首先应该服务真实采购商,同时也可以帮助搜索系统更准确地理解企业。
结语:不必急着禁止 AI,但必须知道开放了什么
Google 计划支持统一 AI 训练控制,意味着网站所有者未来有望通过更简单的方式表达内容使用偏好。
但这不意味着每家企业都必须禁止 AI,也不意味着允许 AI 训练就一定能获得更多流量。
对于大多数以海外客户开发为目的的中国外贸 B2B 企业,我更倾向于:
公开营销内容保持合理的搜索可发现性,敏感商业信息严格保护,AI 训练权限则根据实际需求和官方规则审慎决定。
网站建设的目标始终没有改变——让真正需要企业产品和服务的人,更容易找到可信、准确的信息。
只是未来,帮助客户发现这些信息的,可能不仅是传统 Google 搜索,也包括越来越多的 AI 搜索与检索工具。
参考资料
- Google Search Central,2026 年 10 月 30 日:Supporting a shared AI training control for websites
- Google 官方爬虫文档:Google’s common crawlers — Google-Extended
- IETF Internet-Draft,2026 年 10 月 30 日:Machine-Readable Training Preference Signal
- Google Search Central:Control what you share with Google Search
本文依据截至 2026 年 11 月 2 日的公开官方资料整理。相关标准仍在制定中,具体实现及支持范围应以未来正式公告为准。

